01
Contexte
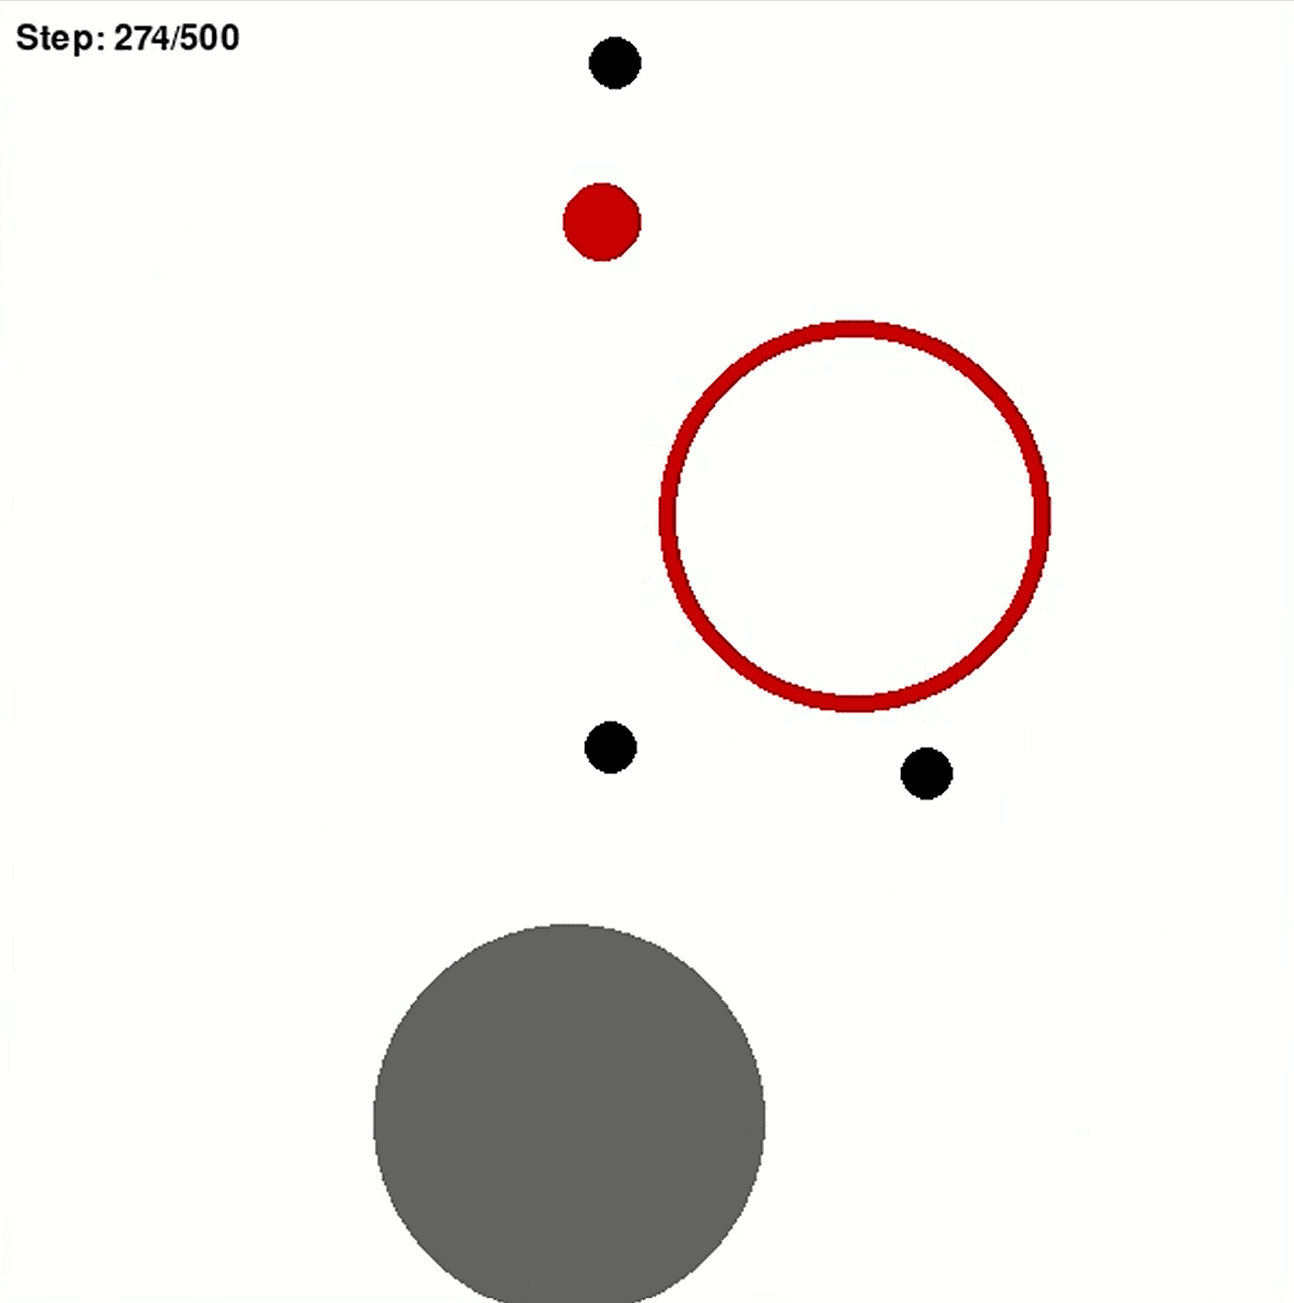
Shepherd-RL est un projet académique de reinforcement learning consacré à un problème de shepherding : un ou plusieurs agents « bergers » apprennent à guider un ou plusieurs « moutons » vers une zone cible, dans un environnement de simulation dont la complexité augmente progressivement.
02
Progression de l’environnement
L’environnement est introduit par niveaux de difficulté croissante. Des agents simples (Lazy, Tipsy, Rule-Based) servent de baselines pour distinguer la difficulté de l’environnement des limites propres aux algorithmes d’apprentissage.
- un berger, un mouton, environnement déterministe
- ajout d’un mouvement stochastique des moutons
- ajout d’un obstacle
- passage à plusieurs moutons puis à deux bergers
03
Algorithmes
Trois familles d’algorithmes ont été comparées : PPO, TD3 et DQN. Sur la configuration la plus simple, TD3 et PPO convergent nettement mieux que DQN. Les performances des trois algorithmes se dégradent à mesure que la complexité de l’environnement augmente.
04
Curriculum et reward shaping
Le passage à plusieurs moutons augmente fortement la difficulté : dispersion du troupeau, stochasticité, observation plus grande, récompense de succès plus rare. Les premières approches de reinforcement learning échouent sur la configuration bruitée à trois moutons, alors que la baseline Rule-Based confirme que l’environnement reste solvable. Le travail s’oriente alors vers le reward shaping, l’augmentation de la capacité des réseaux, le curriculum learning et le fine-tuning : le problème ne se résout pas seulement par le choix de l’algorithme.
05
Coordination multi-agent
La dernière étape introduit deux bergers. Les premières tentatives font apparaître un problème d’observation : le second agent ne dispose pas d’un référentiel correctement centré sur sa propre position. L’environnement est ensuite corrigé avec des observations symétriques et une récompense de proximité, puis un curriculum learning sur une configuration simplifiée avant le retour au troupeau complet.
- étape intermédiaire (deux bergers, un mouton) : TD3 atteint 96 % de réussite
- configuration finale (deux bergers, trois moutons) : TD3 atteint 37 % de réussite sur 100 épisodes, un résultat partiel dans un environnement difficile
06
Limites
Les résultats correspondent à un environnement simulé et à un budget d’entraînement limité. La configuration finale n’atteint pas une convergence complète et reste fortement dépendante du reward shaping, pour un coût de calcul important. Les comparaisons de temps d’entraînement restent imparfaites, car le matériel utilisé a évolué au cours du projet.