01
Problème étudié
Un classifieur de sentiment entraîné sur des critiques Amazon est transféré vers des tweets, un domaine plus court, informel et lexicalement différent. L’objectif est de maintenir un niveau de performance correct sur ce nouveau domaine tout en limitant le budget d’annotation nécessaire.
- Modèle entraîné sur des critiques Amazon
- Transfert vers des tweets — données plus courtes, informelles, lexicalement différentes
- Objectif : maintenir les performances avec un budget d’annotation cible limité
02
Baseline et domain shift
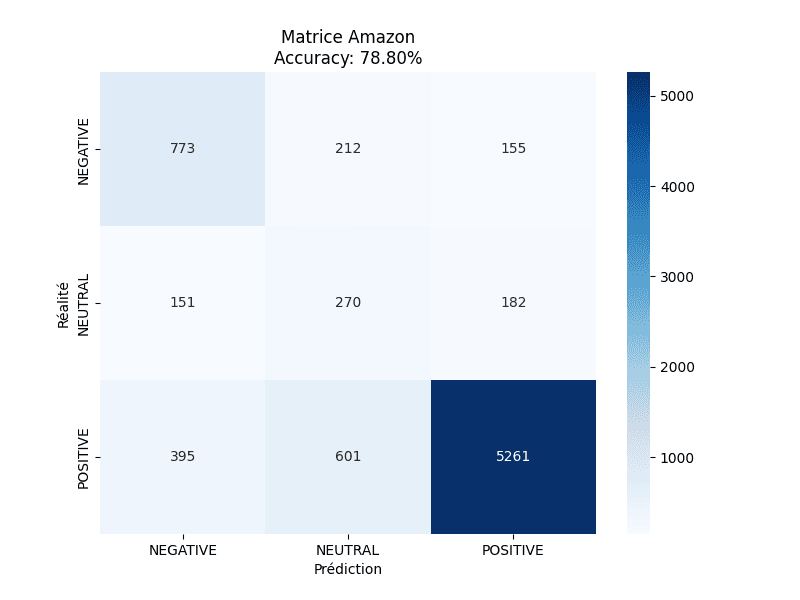
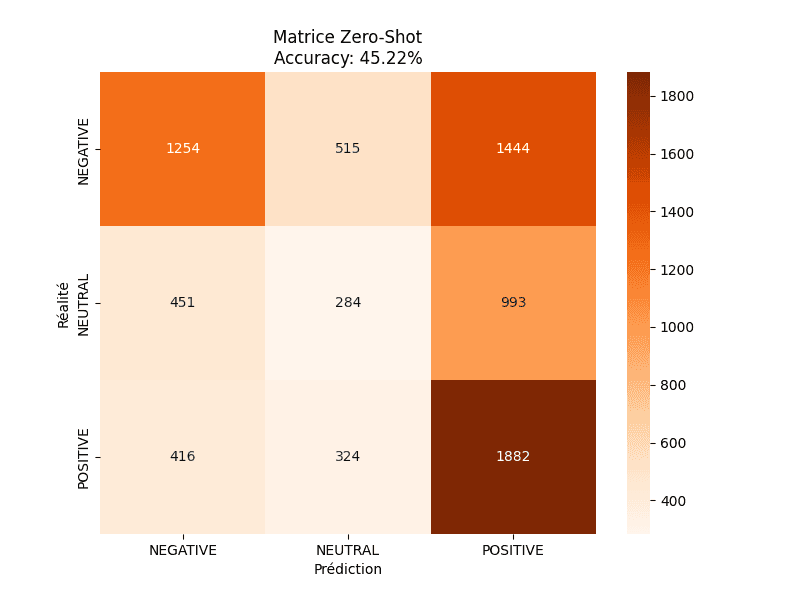
La baseline associe un prétraitement NLP classique, une vectorisation TF-IDF en unigrammes et bigrammes, et une régression logistique sur trois classes — positif, négatif, neutre. Appliquée sans adaptation au domaine Twitter, elle perd l’essentiel de sa performance.
- Amazon → Amazon : environ 79 % d’accuracy
- Amazon → Twitter (zero-shot, sans adaptation) : environ 45 % d’accuracy
03
Apprentissage actif
Plutôt que d’annoter le domaine cible au hasard, une stratégie d’apprentissage actif sélectionne à chaque budget les tweets jugés les plus utiles à annoter pour adapter le modèle.
- Incertitude — Entropy Sampling, Margin Sampling
- Diversité / représentativité — Diversity (K-Means), Density, Max Distance
- Hybride — combinaison normalisée d’Entropy et de Margin
04
Comparaison des stratégies
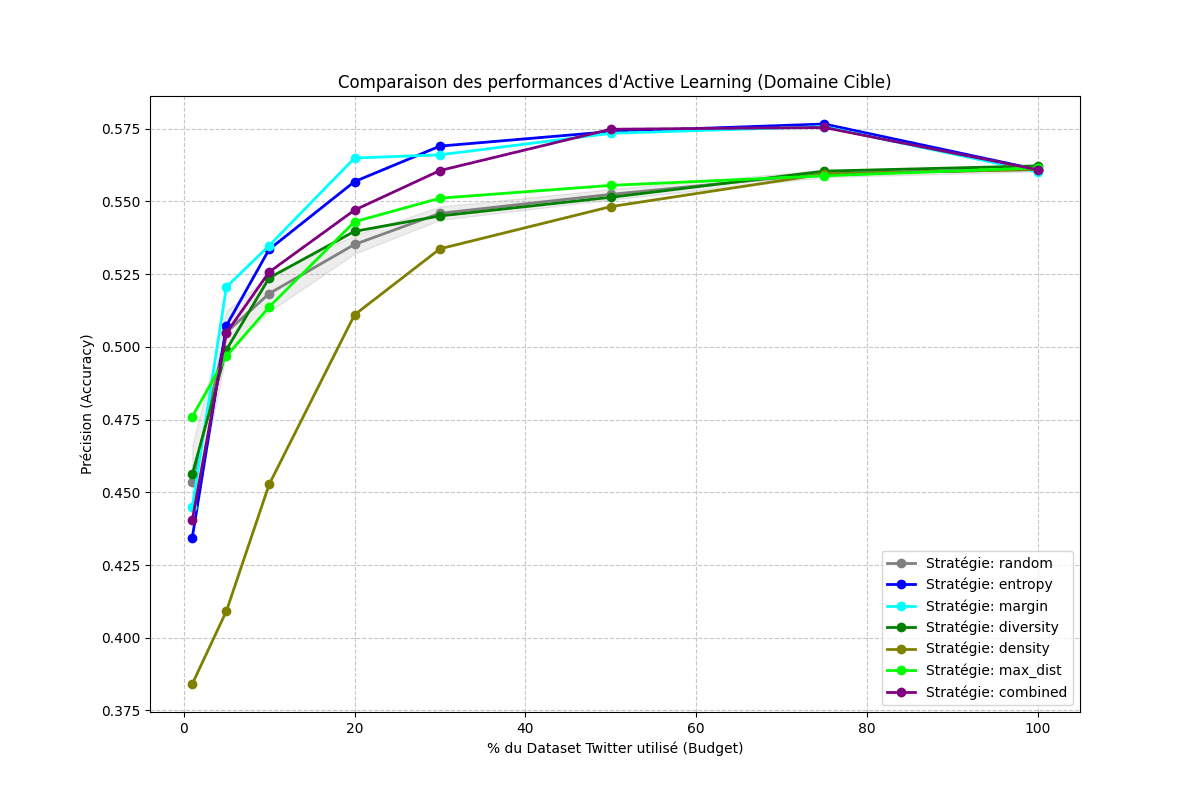
Les stratégies fondées sur l’incertitude sont les plus efficaces dans les premiers budgets d’annotation. Margin et Entropy dépassent nettement la sélection aléatoire, tandis que Density est nettement moins adaptée à ce domaine. Les différentes stratégies convergent progressivement lorsque le budget augmente.
05
Focus Margin
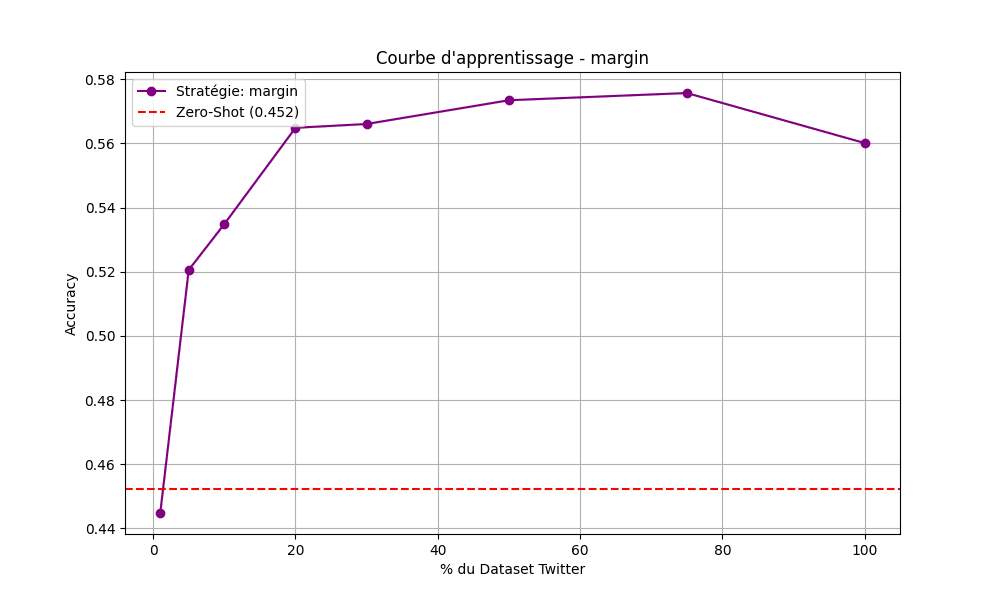
Margin Sampling se distingue comme la stratégie la plus intéressante sur les premiers budgets : la performance progresse rapidement avec peu d’exemples annotés, puis sature progressivement. Cela confirme l’intérêt de sélectionner des exemples informatifs plutôt que d’annoter au hasard.
06
Analyse qualitative
Le choix mathématique d’une stratégie change concrètement la nature des exemples annotés. Margin et Entropy privilégient des tweets plus ambigus ou riches en information, utiles pour déplacer la frontière de décision, tandis que Density sélectionne davantage de messages courts et redondants, ce qui explique sa faible efficacité sur ce domaine bruité.
07
Limites
La représentation TF-IDF reste fortement dépendante du vocabulaire observé sur le domaine source. Le vocabulaire Twitter diffère fortement de celui d’Amazon, et une part importante des termes du domaine cible reste hors vocabulaire, ce qui plafonne mécaniquement les performances. Les conclusions restent limitées aux datasets et au protocole expérimental retenus.